
t-近似性(t-closeness)——「全体との違い」からプライバシーを考える
著者名:南 和宏, 岩崎 香具矢(編集), 服部 優子(挿絵)
作成日:2026.11.20
テクニカルレポートNo.14
1. はじめに
第3回の記事では、個人が特定されるリスクを低減するため、同じ準識別子の値を持つレコードを少なくとも k 個そろえる「k-匿名性」※を紹介しました。続く第7回の記事では、個人のレコードを特定できなくても、その人の病名などが分かってしまう問題と、それに対処する「ℓ-多様性」※を説明しました。ℓ-多様性は、それぞれの等価クラス※に含まれる機密属性の値に多様性を持たせることで、個人の機密情報が推測されるリスクを低減する考え方です。
しかし、第7回の記事の最後では、値に多様性があっても、機密情報が推測される場合があることを紹介しました。では、こうしたリスクを低減するには、どのような点に注目すればよいのでしょうか。
そこで重要になるのが、データ全体との違いです。特定のグループ(以下、等価クラス)に含まれる機密情報の割合が、データ全体の割合と大きく異なっていると、その等価クラスに属する人の機密情報が推測されやすくなる場合があります。このような違いに注目するのが、今回紹介する「t-近似性」です。
2. ℓ-多様性を満たしていても、秘密が推測される?
第7回の記事「ℓ-多様性 (ℓ-diversity) —— k-匿名性だけでは守りきれないもの」で紹介した「偏り攻撃」※を振り返ってみましょう。
例えば、ある検査データでは、全体の陽性者の割合が1%(1万人中100人)だったとします。ところが、ある等価クラスでは陽性と陰性が半数ずつでした。(10人中5人ずつ)この等価クラスには陽性と陰性の2種類の値が均等に含まれており、ℓ-多様性の条件を満たしています。そのため、誰が陽性なのかを特定することはできません。しかし、その等価クラスに属する人については、全体の1%ではなく、50%という割合をもとに、陽性である可能性が大幅に高いと推測されてしまいます。[1]
もう一つの問題は「類似性攻撃」※です。例えば、ある等価クラスに含まれる機密属性「病名」の値が「胃炎・胃潰瘍・胃がん」と異なっていても、すべて胃の病気であるため、その等価クラスに属する人が胃の病気を持つことは分かってしまいます。[1]
以上のことから、等価クラス内の機密情報に多様性があるだけでは、プライバシーを十分に保護できない場合があることが分かります。そこで重要になるのが、データ全体と各等価クラスの機密情報の分布を比較するという考え方です。
3. t-近似性の考え方とは
2007年、Ninghui Li、Tiancheng Li、Suresh Venkatasubramanianは、「t-近似性(t-closeness)」※を提案しました。その要件は、次のように定義されます。[1]
すべての等価クラスについて、機密属性の分布とデータ全体の機密属性の分布との距離が、しきい値 t 以下であること。(図1)
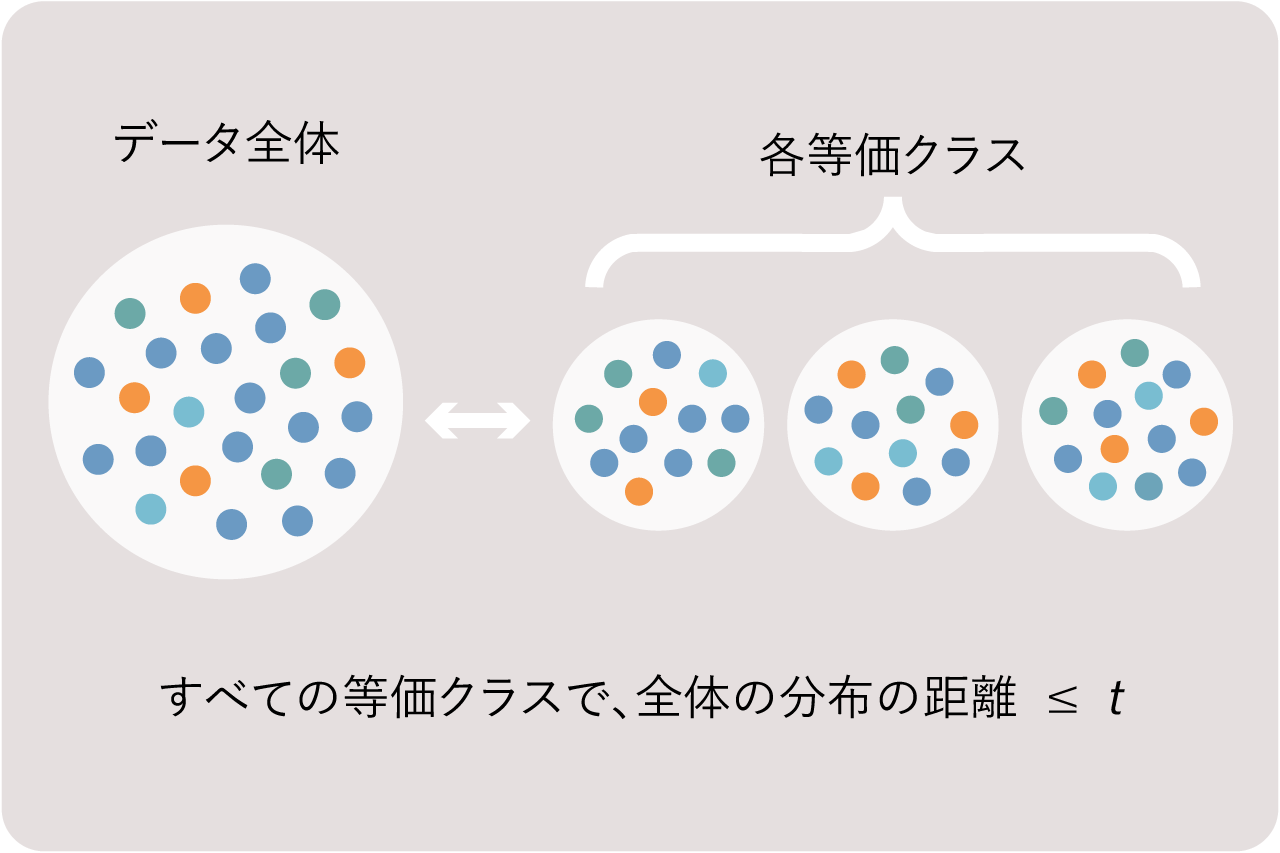
図1. t−近似性の概念
ここでいう「分布」※とは、それぞれの値がどのくらいの割合で現れるかということです。例えば、検査結果が「陽性20%、陰性80%」なら、それが検査結果の分布です。「データ全体」とは、世間一般の人々ではなく、対象とするデータに含まれる全レコードを指します。
t-近似性では、各等価クラスの機密属性の分布が、データ全体の分布とどの程度近いかに注目します。
4. 具体例:全体と等価クラスを比べてみる
架空の100人分の検査データを考えましょう。全体では陽性者が20人、陰性者が80人います。以下の数値例は、t-近似性を説明するために作成したものです。
このデータについて、年齢を一般化した結果、次の3つの等価クラスができたとします。なお、説明を簡単にするため、準識別子は年齢だけとします。
表1.各等価クラスの検査結果
| 等価クラス | 年齢 | 人数 | 陽性 | 陰性 | 陽性の割合 |
|---|---|---|---|---|---|
| A | 30代 | 10人 | 5人 | 5人 | 50% |
| B | 40代 | 30人 | 3人 | 27人 | 10% |
| C | 50代 | 60人 | 12人 | 48人 | 20% |
| 全体 | – | 100人 | 20人 | 80人 | 20% |
表1を見ると、すべての等価クラスに陽性と陰性の両方が含まれるので、異なる値の種類数を数える distinct ℓ-多様性では、ℓ=2を満たしています。
しかし、ある人がこのデータに含まれ、30代だと分かっている場合はどうでしょうか。その人の候補は等価クラスAの10人に絞られ、その半数が陽性です。等価クラス内でほかに区別する手がかりがなければ、全体の陽性割合20%よりも、等価クラスAの50%というかなり高い割合をもとに推測されることになります。
では、この違いをt-近似性ではどのように評価するのでしょうか。
ここでは、陽性と陰性の間の距離を1として、後述するEMDという方法で分布の距離を測ります。今回のように検査結果が陽性と陰性の2値の場合、分布間の距離は「陽性割合の差の絶対値」になります。
図2では、データ全体と各等価クラスの検査結果の分布を並べて比較したものです。棒グラフの棒の長さは人数ではなく割合を表し、各行の合計が100%になるようにそろえています。
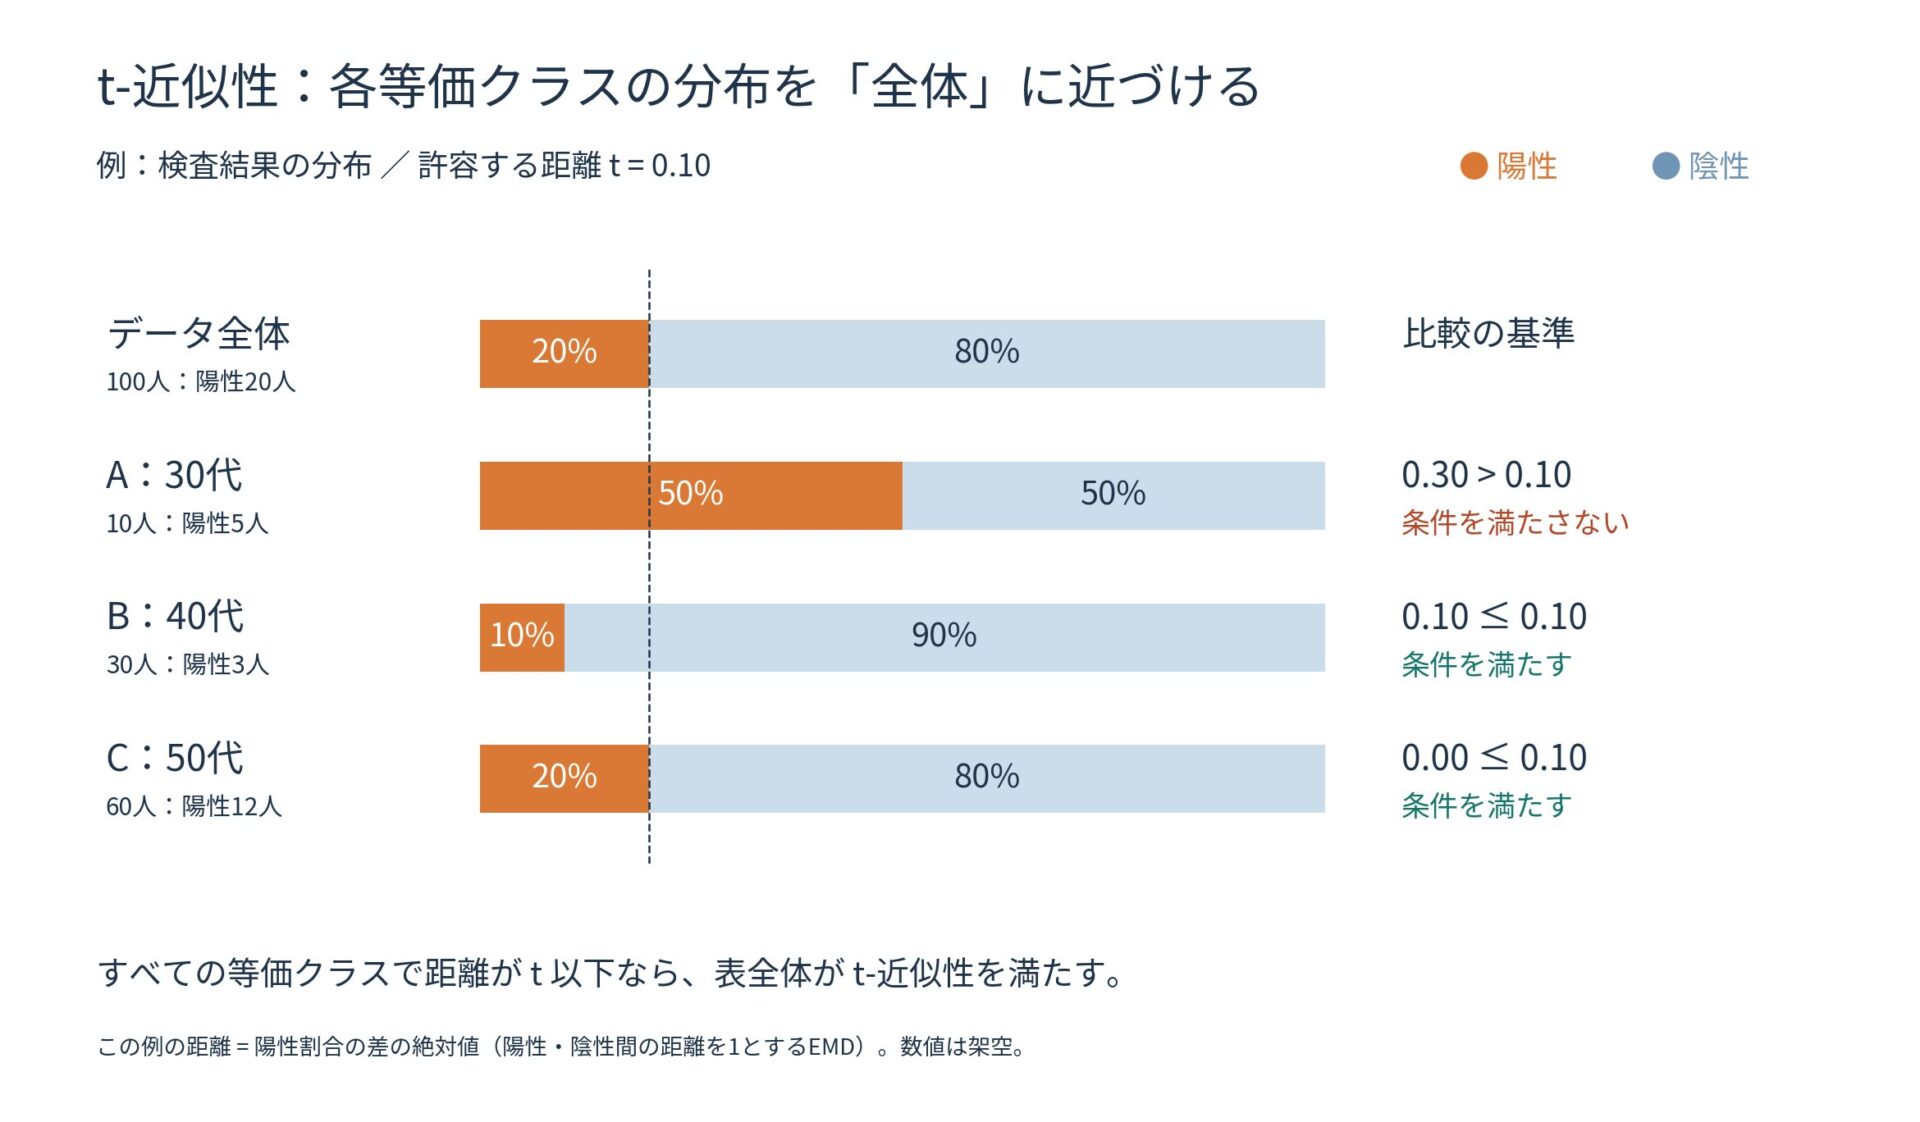
図2. t-近似性におけるデータ全体と各等価クラスの分布比較
等価クラスAとデータ全体の分布の距離は、0.50 − 0.20=0.30です。同様に、等価クラスBは0.10、等価クラスCは0.00になります。
この例では、しきい値がt=0.10なら、全体との差を10パーセントポイント以内に抑える必要があります。等価クラスBとCは条件を満たしていますが、等価クラスAは満たしていません。t-近似性では、すべての等価クラスが条件を満たす必要があるため、このデータはt=0.10のt-近似性を満たしていないことになります。
なお、t=0.10は「個人を特定される確率が10%以下」という意味ではありません。あくまで、選んだ距離の測り方における、分布の違いの上限です。
5. どう加工すれば条件を満たせるのか
表1のデータをt-近似性の条件に近づけるには、等価クラスAとBをまとめる方法が考えられます。年齢を「30代」「40代」と分けず、「30~49歳」に一般化してみましょう。
表2.等価クラスAとBをまとめた後の検査結果
| 等価クラス | 年齢 | 人数 | 陽性 | 陰性 | 陽性の割合 |
|---|---|---|---|---|---|
| AとBを統合 | 30~49歳 | 40人 | 8人 | 32人 | 20% |
| C | 50代 | 60人 | 12人 | 48人 | 20% |
| 全体 | – | 100人 | 20人 | 80人 | 20% |
統合した等価クラスの陽性割合は、8÷40=20%です。等価クラスCも20%なので、どちらも全体の分布と一致します。この表は、t=0.10の条件を満たします。さらに、この例では距離がどちらも0なので、t=0でも条件を満たします。
ここで注目したいのは、検査結果そのものは変更していないという点です。変更したのは、誰がどのレコードに対応するかを絞り込む手がかりである年齢です。
一方、加工前には分かった「30代と40代で陽性割合が異なる」という特徴は、公開データから読み取れなくなりました。ここに、プライバシー保護とデータの有用性とのトレードオフが現れています。つまり、プライバシーを保護するためにデータを加工すると、分析に役立つ情報が失われる場合もあるということです。
6. 病名や収入の「近さ」をどう扱う?
先ほどの例は陽性・陰性の2種類でしたが、収入や病名のように多くの値がある場合には、値どうしの違いも考慮して分布の距離を測る必要があります。
原論文が採用したのは、分布間の距離を測るためのEarth Mover’s Distance(EMD)と呼ばれる距離尺度です。一方の分布をもう一方に変えるために、割合をどれだけ、どのくらい遠くへ移す必要があるか、その最小の仕事量として距離を測ります。値どうしの距離を設定することで、数値や意味の近さを反映できます。
イメージとしては、値ごとの割合を砂の山に見立てるとよいでしょう。ある形の砂山を別の形にする際、少しの砂を近くに動かすだけなら仕事は小さく、大量の砂を遠くまで運ぶなら仕事は大きくなります。
例えば収入の場合、300万円と310万円の違いは比較的小さい一方、300万円と1,000万円の違いは大きいと考えられます。EMDでは、こうした値どうしの近さや遠さを反映した距離を設定できます。病名についても、病気の分類に基づいて距離を設定することが考えられます。
ただし、EMDの仕組み自体が病名の意味を自動的に理解するわけではありません。どの分類を使い、何を近いとみなすかを決める必要があります。また、tの数値だけではプライバシー保護の条件の厳しさは判断できず、距離の定義と併せて考えることが大切です。
7. t-近似性が守ろうとするもの
t-近似性では、データ全体の傾向を隠すのではなく、ある人がどの等価クラスに属しているかが分かることで、その人の機密情報について新たな推測ができてしまうリスクを抑えるための考え方です。全体の傾向そのものを隠すことは目的としていません。[1]
例えば、表2から「このデータでは20%が陽性」という傾向は分かります。しかし、「ある人は30代だ」という情報を追加しても、対応する等価クラスの陽性割合は同じ20%です。この範囲では、等価クラスが分かったことによって推測は変わりません。
ただし、t-近似性を満たしていれば、すべてのプライバシーリスクを防げるわけではありません。その人に関する別の情報があれば、それらを組み合わせることで、機密情報についてさらに推測できる可能性があります。
また、tの値を小さくすれば、許される分布の違いは小さくなります。その反面、表2のように年齢区分などを広げる必要が生じ、細かな集団間の違いを分析しにくくなる場合があります。原論文でも、準識別子と機密属性の関連を制限することが、プライバシー保護と有用性の両方に影響する点が論じられています。[1]
どの違いを残すと分析に役立ち、どの違いが個人の秘密の推測につながるのか。t-近似性は、データ全体と各等価クラスの分布の距離に注目し、個人のプライバシーを保護しながら、データの有用性とのバランスを考えるための一つの指標です。
用語解説
- 偏り攻撃・・・特定の等価クラスにおける機密情報の分布がデータ全体と大きく異なることを利用して、個人の機密情報を推測する攻撃。
- 類似性攻撃・・・等価クラス内に異なる機密情報が含まれていても、それらの意味や性質が似ていることを利用して、個人の機密情報を推測する攻撃。
- t-近似性(t-closeness)・・・各等価クラスの機密情報の分布とデータ全体の分布との差を一定の範囲内に抑えることで、個人の機密情報が推測されるリスクを低減する考え方。
- 分布・・・それぞれの値が現れる割合。例えば「陽性20%、陰性80%」。
- EMD(Earth Mover’s Distance)・・・分布を別の分布へ変える際の、移す量と移動距離に基づく距離の尺度。
過去の記事で登場した専門用語
参考文献
- Ninghui Li, Tiancheng Li, and Suresh Venkatasubramanian, “t-Closeness: Privacy Beyond k-Anonymity and ℓ-Diversity,” Proceedings of the 23rd IEEE International Conference on Data Engineering (ICDE 2007), pp. 106–115, 2007.