AliceとBobは誰?――暗号技術の世界から考える、データを安全に使う方法
著者名:岩崎 香具矢, 南 和宏(監修), 服部 優子(挿絵)
作成日:2026.10.23
テクニカルレポートNo.11
暗号や情報セキュリティの説明を読んでいると、「Alice(アリス)」と「Bob(ボブ)」という名前を目にすることがあります。AliceがBobに秘密のメッセージを送ったり、二人がそれぞれ持っているデータを使って何らかの計算をしたりします。
AliceとBobは実在する人物ではありません。情報セキュリティや暗号の分野で、通信や情報のやり取りをする二者を表すために長年使われてきた架空の登場人物です。 Rivest・Shamir・Adlemanによる、RSA暗号の論文[1]は公開鍵による暗号化と電子署名の具体的な実現方法を示した画期的な論文ですが、その後の暗号分野の論文に多く採用されたAliceとBob が初めて登場したことでも知られています。単に「A」と「B」と呼ぶよりも、例えば 「Aliceはこの情報を持っているが、Bobにはこの情報を見せたくない」と人物に見立てて説明することで、誰が何を知っているのかを整理しやすくなります。
従来、暗号技術の研究では、AliceとBobがメッセージをやり取りする場面を想定し、その内容を暗号化することで、通信を盗み見ようとする攻撃者から情報を守る方法が長年研究されてきました。
一方、SDC4Societyプロジェクトでは、異なるデータを持つAliceとBobが、お互いの元データを明らかにすることなく、それぞれのデータを組み合わせた分析を行うための技術についても研究しています。(図1)
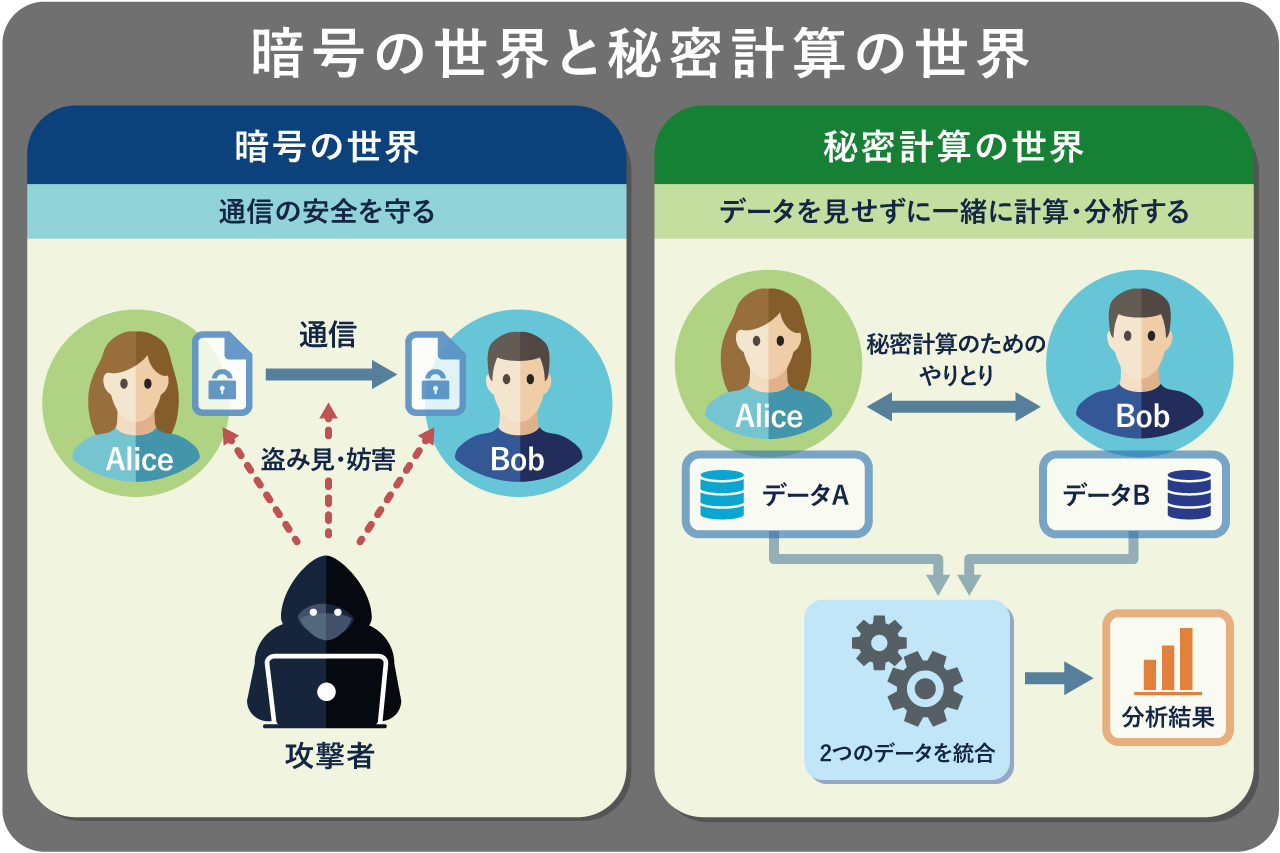
図1. 暗号の世界と秘密計算の世界
このAliceとBobを使って、少し具体的な問題を考えてみましょう。AliceとBobは、それぞれ別の組織に所属し、異なるデータを持っています。二つのデータを組み合わせれば、一方のデータだけでは分からなかったことを分析できそうです。しかし、だからといって、お互いのデータをそのまま交換してよいとは限りません。
では、AliceとBobはどうすれば、互いのデータを守りながら一緒に分析できるのでしょうか。
データを組み合わせるには何が必要?
複数のデータを組み合わせることは、データ分析では珍しいことではありません。たとえば、あるデータには人の年齢や居住地域が記録され、別のデータにはサービスの利用状況が記録されているとします。この二つを適切に結び付けることができれば、「どのような人が、どのようなサービスを利用しているのか」といった、一つのデータだけでは分からなかった関係を分析できるようになります。
行政機関、医療機関、研究機関、企業など、社会には異なる組織のもとに多くのデータが分散しています。それらを安全に活用できれば、新しい知見を得たり、社会の状況をより詳しく把握したりできる可能性があります。一方で、別々に存在していたときには分からなかった情報が、結び付けることで分かるようになることもあります。これはデータ統合の価値そのものですが、同時にプライバシー上の注意点でもあります。
AliceとBobのデータを組み合わせるには、まず「どのレコード※とどのレコードが同じ人や同じ対象を表しているのか」を判断する必要があります。このように、異なるデータに含まれるレコードを対応付けることを、データリンケージと呼びます。その方法には、氏名や生年月日などがあらかじめ定めた条件で一致するかどうかによって判断する「決定的マッチング※」や、複数の項目の一致・不一致をもとに、2つのレコードが同じ人物を表している可能性を評価する「確率的マッチング※」などがあります。[2]
例えば、両方のデータに同じIDが付いていれば、そのIDの一致を条件としてレコードを対応付けることができます。これは、あらかじめ定めた条件に基づいて対応付ける「決定的マッチング」の一例です。一方、現実のデータでは、共通するIDがなかったり、氏名の表記が異なっていたり、住所の書き方が違っていたり、一部の情報が欠けていたりすることがあります。そのような場合には、複数の項目の一致・不一致を手掛かりに、「この二つのレコードは同じ人物である可能性が高い」と判断する「確率的マッチング」の方法が用いられます。[2]
これらは同じ人物や対象のレコードを対応付ける方法ですが、データを組み合わせるには、別の考え方もあります。その一つが「統計的マッチング※」です。統計的マッチングとは、必ずしも同じ人物のレコードを対応付ける必要はなく、共通する項目や統計的な関係を利用して異なるデータを組み合わせる方法です。[3]
ここで重要なのは、データリンケージが単に「二つの表をくっつける」作業ではないということです。間違ったレコードを結び付ければ分析結果そのものが誤りますし、正確に対応付けようとして多くの個人情報を利用すれば、今度はプライバシー上のリスクが高まる可能性があります。つまり、データを正しく結び付けることと、安全に結び付けることの両方を考える必要があります。
相手に見せずに処理できる?
ここで、高機能暗号※を用いた秘匿計算・照合技術について考えてみましょう。その具体例の一つに、PSI(Private Set Intersection)※があります。[4]
PSIも、AliceとBobが持つデータの中から「両方に共通するもの」を見つける技術です。その意味ではデータリンケージと少し似ていますが、二つは同じものではありません。データリンケージの中心的な問いは、「このレコードとこのレコードは同じ人なのか」です。一方、PSIの中心的な問いは、「二つの集合に共通する要素を、互いの集合全体を見せずに求められるか」です。
つまり、データリンケージが「誰と誰を対応付けるか」を考える技術だとすれば、PSIは「その照合を、互いの元データを明らかにせずに行うにはどうするか」を考える技術の一例と見ることができます。
では、AliceとBobがお互いに元データを見せられないとき、第三者に預ければよいのでしょうか。たとえば、AliceとBobがそれぞれ信頼できる第三者にデータを渡し、その第三者が照合や分析を行って結果だけを返す方法が考えられます。この方法なら、AliceがBobの元データを見ることも、BobがAliceの元データを見ることもありません。
しかし、その場合は今度は「その第三者をどこまで信用してよいのか」という問題が生じます。AliceとBobのデータは一か所に集まるため、その第三者のシステムが攻撃を受ければ、両方の情報が同時に漏れる可能性があります。
そこで生まれるのが、そもそも元のデータを誰か一か所に集めなくても、必要な処理だけを実行できないかという発想です。[4]
たとえば、Aliceが「田中、渡辺、佐藤、鈴木」という4人のIDを持ち、Bobが「佐藤、鈴木、高橋、山本」という4人のIDを持っているとします。単純に一覧を交換すれば、佐藤と鈴木が共通していることは分かります。しかしその場合、Aliceは高橋や山本について知り、Bobは田中や渡辺について知ることになります。
PSIを用いれば、互いの集合全体を明らかにせず、共通する要素を求めることができます。[4]
さらに、分析に必要なのが「誰が共通しているのか」ではなく、「共通する人が何人いるのか」という件数だけであれば、PSI-CA(Private Set Intersection Cardinality)※のように、共通要素そのものではなく、その件数だけを求める方法もあります。[5]
この例であれば、佐藤と鈴木という具体的な共通要素を明らかにせず、「共通する人は2人」という結果だけを得ることになります。ここにあるのは、目的に必要な情報だけを得て、それ以上の情報はなるべく明らかにしないという考え方です。
安全に計算できても終わりではない
では、AliceとBobがお互いの元データを明らかにせず、必要な結果を安全に計算できたとしましょう。これでプライバシーの問題はすべて解決したのでしょうか。
そうとは限りません。
たとえば、ある地域について特定の条件に当てはまる人数を計算したところ、「1人」という結果が得られたとします。計算の途中では個人データは公開されていません。しかし、その地域や条件が十分に限定されていれば、周囲の情報と組み合わせることで、その1人が誰なのか推測できる可能性があります。
ここで重要なのは、計算過程でデータを守ることと、計算結果から情報が漏れないようにすることは別の問題であるという点です。高機能暗号によって処理の途中を守ることができても、最終的な結果が詳細すぎれば、その結果自体が情報漏えいにつながる可能性があります。
つまり、安全なデータ利用には、
- 結び付けること
- 見せずに処理すること
- 結果を安全な形で出すこと
という、それぞれ異なる課題があります。
結果をどう守る?
この「結果から何が分かってしまうのか」という問題を考えるのが、統計的開示抑制(SDC:Statistical Disclosure Control)※です。
SDCでは、統計データや分析結果を公表・共有するときに、そこから個人や組織の機密情報が推測される危険性を評価し、そのリスクを抑える方法を考えます。たとえば、人数が極端に少ない集計値を秘匿したり、細かすぎるカテゴリーをまとめたり、値を丸めたりする方法があります。[6]
ただし、SDCは最後に結果を見て「安全」「危険」と判定するだけではありません。どのような条件なら開示リスクが高いのか、どの程度まで情報を加工すれば安全性を高められるのか、そのときデータの有用性をどれだけ残せるのかといった評価方法や基準そのものも研究対象です。
つまり、SDC基礎研究には、安全にデータを利用・公開するための「ものさし」を作る役割があります。そのものさしに基づいて、開示リスクと有用性のバランスを評価し、必要に応じて適切な保護方法を選びます。
結果から個人について分かりすぎないようにする方法の一つとして、差分プライバシーもあります。ある統計値を計算するとき、一人のデータを追加したり取り除いたりしただけで結果が大きく変わるのであれば、その変化から、その人について何らかの情報を推測できる可能性があります。
差分プライバシー※では、結果に適切なランダム性を加えるなどして、一人のデータの有無が結果に与える影響を制限します。それによって、データ全体の傾向は利用しながら、個々の人について得られる情報を抑えることを目指します。[7]
ただし、プライバシーを強く守ろうとして結果を大きく変化させれば、今度はデータの有用性が低下する可能性があります。ここでも、安全性と有用性をどのように両立するかが重要になります。
4つの研究はどう関わる?
ここまでのAliceとBobの話を整理すると、安全なデータ利用にはいくつか異なる課題があることが分かります。
- 結び付ける
→ データリンケージ・データ統合技術 - 見せずに処理する
→ 高機能暗号を用いた秘匿計算・照合技術 - 出力をプライバシー保護された形にする
→ 差分プライバシーや各種SDC技術 - その安全性・有用性を評価し、適切な方法を選ぶための基準を考える
→ SDC基礎研究
ただし、これは単純な一本道ではありません。たとえば、データリンケージとPSIのように、複数の技術が同じ「照合」という場面で関わることがあります。また、高機能暗号の中でSDCの処理そのものを実行したり、データ統合後の開示リスクを評価したりするなど、それぞれの研究領域は互いに重なりながら利用されます。
重要なのは、これらを別々の技術として並べることではありません。データが結び付けられ、処理され、結果として外部に出ていくまでの一連の流れの中で、どこにどのようなリスクがあり、どの技術でそれを抑えるのかを考えることです。
SDC4Societyでは、SDC基礎研究、高機能暗号応用、データ統合技術、差分プライバシーという複数の観点から、こうした課題に取り組んでいます。[8] その中心にあるのは、単に情報を隠すことではありません。必要なデータを安全に結び付け、必要な処理を行い、利用価値のある結果を得ながら、個人や組織の情報が必要以上に明らかにならないようにすることです。
AliceとBobから見える安全なデータ利用
AliceとBobは、暗号の世界ではおなじみの架空の人物です。しかし、二人に「それぞれのデータを安全に使ってください」という課題を与えてみると、現実のデータ活用にも通じるさまざまな問題が見えてきます。
二人のデータの中から同じ人を見つける。必要であれば、その照合や計算を元データを見せずに行う。得られた結果から個人の情報が推測されないように保護する。そして、その安全性と有用性を評価し、どの方法を使うかを考える。
こうして考えると、安全なデータ流通とは、どこか一か所に「プライバシー保護」を施せば完成するものではありません。データを結び付けるところから、計算し、結果を利用・公開するところまで、「誰に、何を、どこまで見せるのか」を一貫して設計することが必要です。
AliceとBobというシンプルな登場人物から始めた話ですが、その先にあるのは、複数の組織が持つデータを安全に結び付け、社会に役立つ形で活用するためにはどうすればよいのか、という大きな課題なのです。
用語解説
- 決定的マッチング・・・あらかじめ定めた条件に基づいて、異なるデータに含まれるレコードを対応付ける方法。例えば、氏名や生年月日などの項目が一致するかどうかを確認し、条件を満たすレコードを同じ人物のものとして判断します。
- 確率的マッチング・・・氏名、住所、生年月日など複数の項目を手掛かりに、2つのレコードが同じ人物や同じ対象を表している可能性を計算し、対応付ける方法。項目が完全に一致していなくても、全体の一致度から同一人物かどうかを判断します。
- 統計的マッチング・・・異なるデータに含まれる情報を、個々の人物を直接対応付けるのではなく、共通する属性や統計的な性質を利用して組み合わせる方法。別々のデータから、より多くの情報を持つデータを作るために用いられます。
- PSI(Private Set Intersection)・・・2者がそれぞれ持つデータの中から、両方に共通する要素だけを、互いのデータ全体を明らかにせずに求めるための技術。
- PSI-CA(Private Set Intersection Cardinality)・・・PSIの一種で、両方のデータに共通する要素そのものではなく、共通する要素がいくつあるかという件数だけを求める技術。
過去の記事で登場した専門用語
参考文献
- Ronald L. Rivest, Adi Shamir, and Leonard M. Adleman, “A Method for Obtaining Digital Signatures and Public-Key Cryptosystems,” Communications of the ACM, Vol. 21, No. 2, pp. 120–126, 1978.
- Claudia Sanmartin et al., “Record Linkage Project Process Model,” Statistics Canada, Catalogue No. 12-605-X, 2017.
- Aura Leulescu and Mihaela Agafiţei, “Statistical Matching: A Model Based Approach for Data Integration: 2013 edition,” Eurostat, Statistical Working Papers, 2013.
- Michael J. Freedman, Kobbi Nissim, and Benny Pinkas, “Efficient Private Matching and Set Intersection,” Advances in Cryptology – EUROCRYPT 2004, LNCS 3027, pp. 1–19, 2004.
- Mingli Wu and Tsz Hon Yuen, “Efficient Unbalanced Private Set Intersection Cardinality and User-friendly Privacy-preserving Contact Tracing,” Proceedings of the 32nd USENIX Security Symposium (USENIX Security 23), pp. 283–300, 2023.
- Anco Hundepool et al., “Handbook on Statistical Disclosure Control,” 2nd ed., 2026.
- Joseph P. Near, David Darais, Naomi Lefkovitz, and Gary S. Howarth, “Guidelines for Evaluating Differential Privacy Guarantees,” NIST Special Publication 800-226, 2025.
- Project SDC4Society, “Overview.” (2026年10月16日閲覧)