
統計データは、どのように守られてきたのか?——統計的開示抑制(SDC)の歴史と技術
著者名:南 和宏, 岩崎 香具矢(編集), 服部 優子(挿絵)
作成日:2026.11.06
テクニカルレポートNo.12
私たちが日常的に目にする人口や世帯数、職業、収入などの統計データ。こうした情報は、社会の実態を知り、政策や研究に役立てるために欠かせないものです。しかし、統計データには、調査に回答した個人や企業の情報が含まれています。こうした情報は、どのように守られているのでしょうか。
第2回の記事では、1998年にマサチューセッツ州の医療データから州知事が特定された事件を紹介しました。そして第3回の記事では、この事件を契機の一つとして、k-匿名性※という匿名化データの安全性を評価する指標が提案され、その後、第7回で紹介したl-多様性など、さまざまなk-匿名性の派生指標が提案されてきた流れを紹介しました。これらの研究は、主にコンピュータサイエンスの研究コミュニティを中心に発展してきました。
しかし、これとは別に、公的統計のコミュニティでも、統計データを安全に公開するための研究が長年行われてきました。それが「統計的開示抑制(Statistical Disclosure Control:SDC)」※です。
公的統計では、国や行政機関が個人や企業を対象に実施した公的統計調査で収集した調査票情報※をもとに、統計表を作成し、公開してきました。(図1)現在では、公的統計に限らず、医療や企業のデータなど、さまざまな分野でも活用されています。
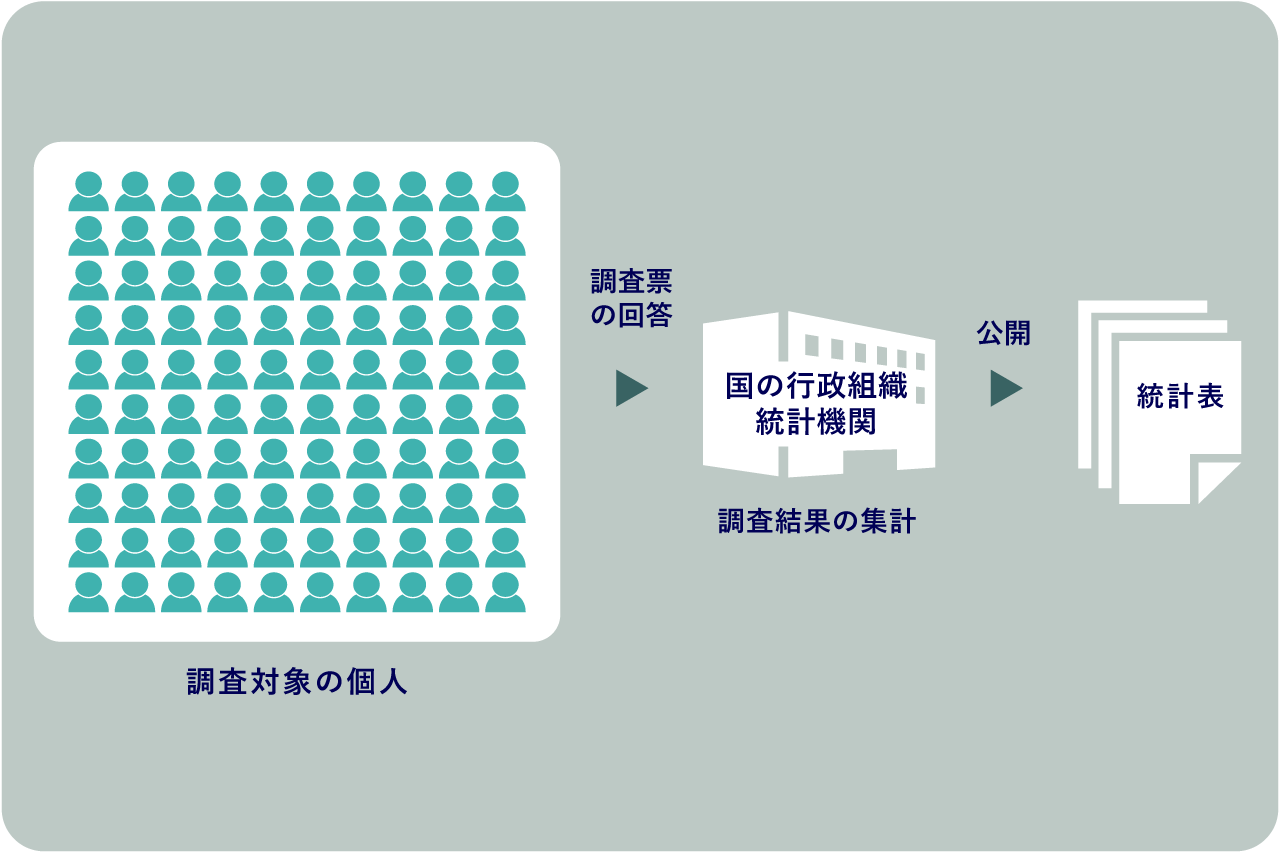
図1. 公的統計調査からの統計情報の公開
統計データのプライバシー保護は、100年以上前から
SDC技術は公開する統計情報の有用性をできるだけ維持しながら、調査に参加した個人や企業の情報が推測されるのを防ぐ目的で発展してきました。米国では国民の人口を調査するセンサス(国勢調査)を1790年から開始しています。しかし、統計情報を公開する際には、個人や企業の情報が明らかになってしまうリスクがあります。
例えば、ある地域に特定の業種の企業が1社しかない場合、その地域の業種別売上高を公表すると、その企業の売上高が推測されてしまう可能性があります。統計表には企業名が書かれていなくても、ほかの情報と組み合わせることで、個々の企業の情報が明らかになってしまうことがあるのです。
こうした問題に対応するため、米国では1920年代には、統計的開示抑制のためのセル秘匿※やカテゴリー統合※等の秘匿処理が実務的に行われるようになりました。その後、1960〜1970年代には研究や方法論の体系化が進みました。 [1][2]
つまり、統計データを安全に公開するための取り組みは、インターネットやAIが登場するはるか以前から続いていたのです。
SDCの研究においても、公開したデータから個人や企業が再識別※されるリスクは重要な研究課題の一つでした。実際、1990年代には、ミクロデータ※に含まれる属性の組合せの「唯一性(uniqueness)」※などに着目して、再識別リスクを評価する研究が行われていました。
こうした考え方には、後に提案されたk-匿名性と共通する部分があります。k-匿名性を提案したSweeney(2002)の論文 [3]では、準識別子※の説明で、Dalenius(1986)のJournal of Official Statisticsの論文[2]を引用しています。この論文でDaleniusは準識別子と呼ばれる複数の属性の組み合わせで個人が再識別される可能性を論じています。このように、異なる研究コミュニティで、類似する問題意識や概念が生まれ、発展していくことは、研究の歴史において決して珍しいことではありません。
では、SDCでは具体的にどのような方法で統計情報を守ってきたのでしょうか。今回は、私たちのプロジェクト「SDC4Society」の名前の由来ともなっている、SDC技術の中から、統計表の数値を安全に公開するための基本的な手法を紹介しましょう。
統計表から個人の収入が分かってしまう?
公的統計では、公開する統計表を主な対象として、個人が識別され、機密情報が推測されたりすることを防ぐための対策が長年研究されてきました。ここでは、図2に示す度数表※と集計表※の具体例で考えてみましょう。図2の度数表※は、ミクロデータを地域と職業の組み合わせで分類し、それぞれに該当する人数を示しています。その下の集計表は同様の組み合わせで対応する個人の収入の合計を示します。
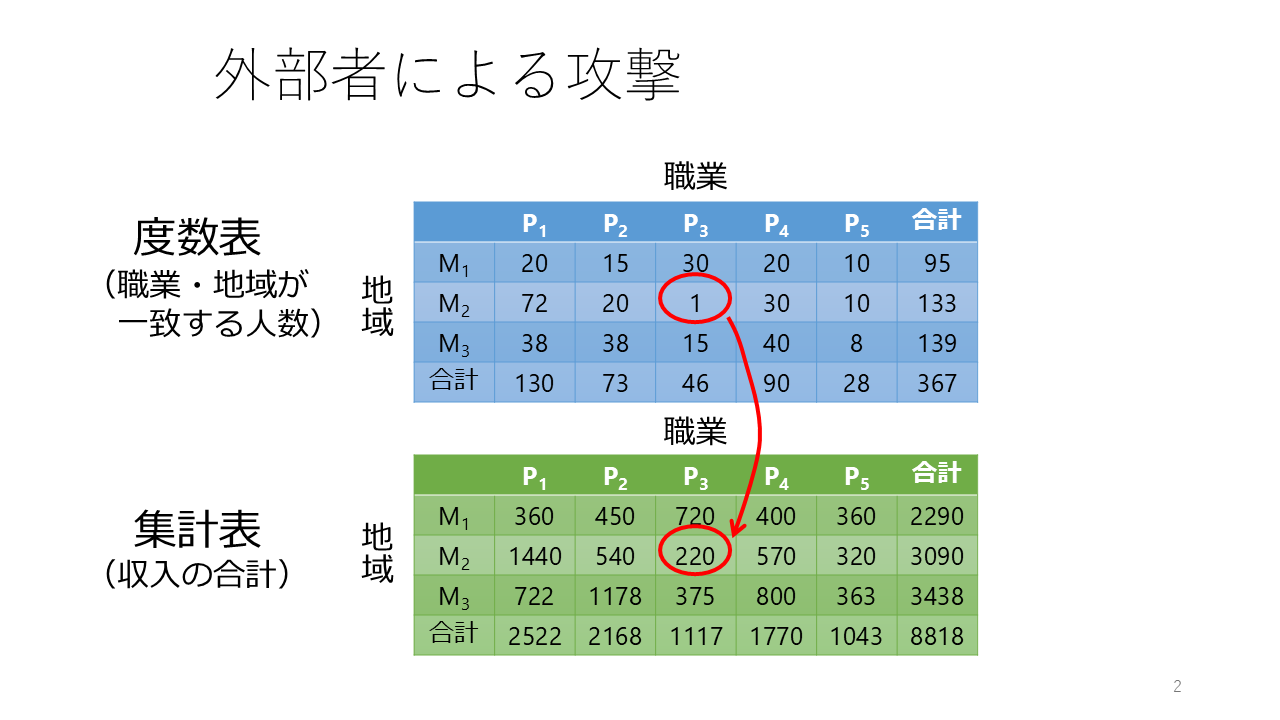
図2. 職業・地域でクロス集計した度数表と集計表
攻撃者は、標的とする人の地域と職業の組み合わせが、(M2, P3) であることを知っているとします。つまり、地域と職業の情報は攻撃者が知り得る準識別子に属することを意味します。図2の度数表では、(M2, P3)の組み合わせに該当する人数は1件なので、攻撃者はその一人が誰であるかを再識別し、さらに集計表の対応するセルの値を参照して、収入が220と知ることができてしまいます。
統計表には個人の名前が記載されていなくても、こうした情報の組み合わせによって、個人の収入などが明らかになる場合があるのです。では、このような情報の漏えいを防ぐには、どうすればよいのでしょうか。
人数が少ないセルを隠す「最小しきい値ルール」
このような統計表における個人の再識別を防止するために、SDCでは統計表に対し、最小しきい値ルール[4]を適用してきました。最小しきい値ルールとは、度数表の各セルに含まれる人数や件数が、あらかじめ定めた値より少ない場合、その数値を秘匿するルールです。例えば、しきい値が3なら、1人や2人のセルを秘匿し、個人の情報が推測されるリスクを抑えます。
最小しきい値ルールのしきい値tは、一定数以上の個人や企業を含む集団を確保するという点で、k-匿名性におけるk値と共通する考え方を持っています。ただし、両者は対象とするデータや安全性の評価方法が異なります。
それでは、人数の少ないセルを隠してしまえば、統計表は安全に公開できるのでしょうか。実は、隠したはずの数字が、簡単な計算で分かってしまうことがあります。
隠した数字が、計算すると分かってしまう?
SDCにおいては、通常最小しきい値より小さいセルの値は図3のように秘匿します。これを1次秘匿と呼びます。ただし、隠したいセル値のみ秘匿しても、表の行計、列計の値が分かるので、次のような計算で元の値を復元できてしまいます。
133-(72+20+30+10) = 1
つまり、せっかく隠したセルの値が「1」であることが、簡単な引き算だけで分かってしまうのです。これでは、数字を隠した意味がありません。したがって、隠したいセル値を秘匿するためには、他の公開可能なセル値も追加で秘匿する必要があります。これを2次秘匿と呼びます。
図3の例では、(M2,P3)のセル値を隠すために、周辺の(M2,P4), (M3, P3), (M3, P4)の3つのセル値を追加で2次秘匿しています。この2次秘匿処理により、(M2,P3)のセル値は0〜16の範囲の値を取る可能性があり、それ以上の値の絞り込みができません。
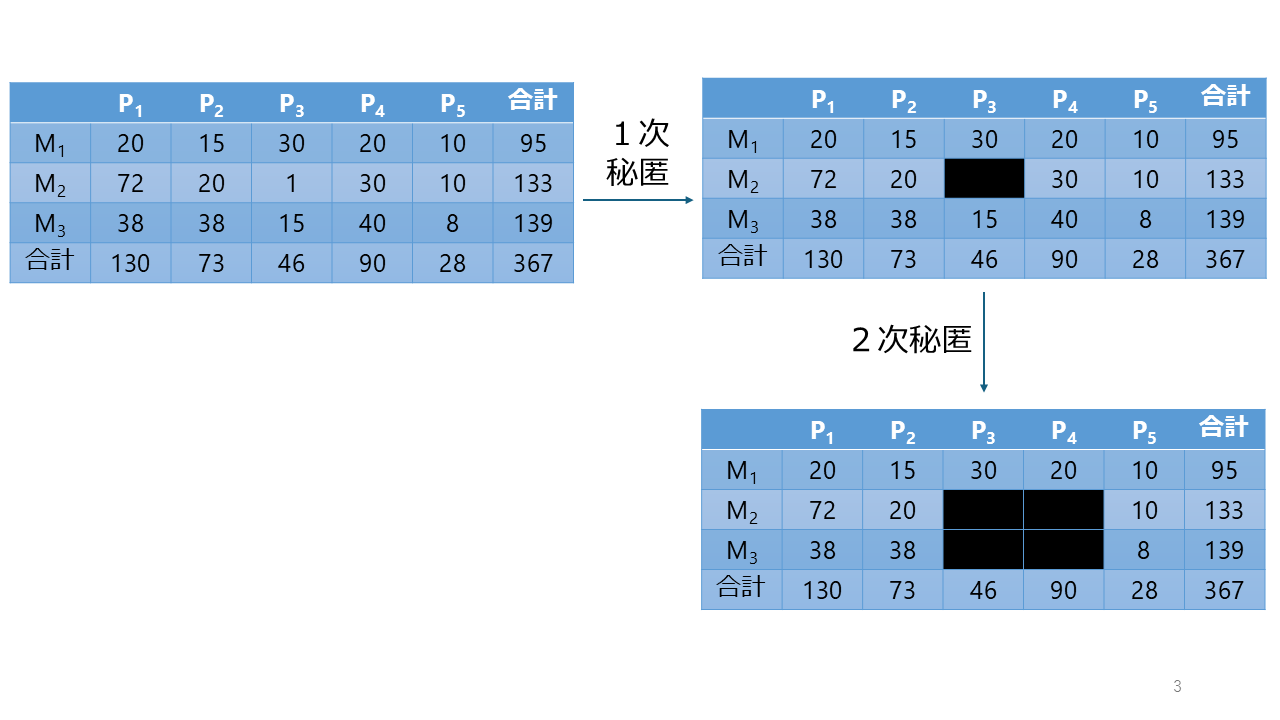
図3. 統計表の2段階のセル秘匿処理
このように、統計表の数値を安全に公開するには、単に危険なセルを隠すだけでなく、ほかの数値から逆算されないようにする工夫も必要なのです。
たくさんの数字を隠せば、安全になる?
それでは、秘匿するセルを増やせば、必ず安全になるのでしょうか。実は、2次秘匿するセルの場所を決めるのは案外難しく、適切に選ばないと元の値が特定されてしまいます。
図4の統計表のセル秘匿を見てみましょう。この例では最小しきい値を10としていて、(A1, B1)のセル値を秘匿する必要があります。そのため、図4の下の表のように、合計9個のセル値を秘匿しています。図4では、秘匿されたセル値をx1, x2,…,x9の変数で示しています。
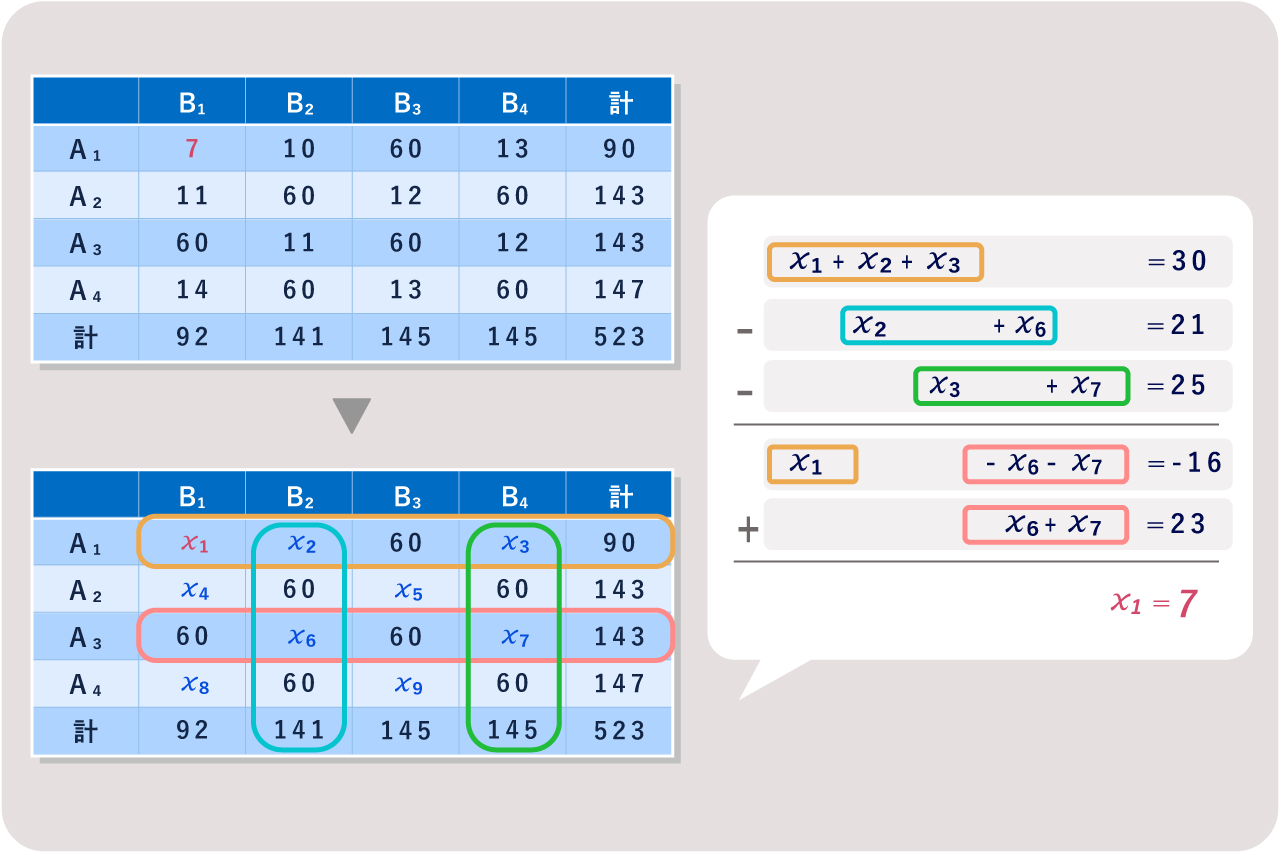
図4. 安全でない表セルの秘匿処理
9個ものセルを秘匿しているため、一見すると元の値を特定するのは難しそうです。しかし、統計表の行計から決まる方程式を図4のように解くと、x1の値は7となり、復元されてしまいます。
つまり、隠すセルの数を増やすだけでは、必ずしも安全になるわけではありません。どのセルを隠すかが重要なのです。図4の例が示すように、統計表の2次秘匿処理を人間が手作業で行うことは難しく、一般には、表データの2次秘匿処理を実施するツール(プログラム)が必要になります。
ただし、秘匿するセルを増やしすぎると、公開される統計情報が少なくなり、データの有用性が損なわれてしまいます。そのため、2次秘匿処理ツールは、1次秘匿するセル値の不確定性(取り得る値の範囲)を確保しつつ、2次秘匿するセル数を最小化するという最適化問題を解くことになります。[4] 統計情報を安全に公開しながら、その有用性をできるだけ維持すること。この両立を目指すのが、SDC技術の重要な役割なのです。
まとめ
k-匿名化と表セル秘匿は、個人の再識別や機密情報の開示を防ぐという共通の問題意識から発展してきました。統計表の分類に用いる変数が準識別子の場合、k-匿名性のk値と表セル秘匿問題の最小しきい値には一定数以上の対象を確保するという考え方に共通点があります。しかしながら、公開する情報の安全性を確保するための秘匿処理の方法については異なるアプローチをとっています。
k-匿名化では、ミクロデータの値を一般化※することで、類似するレコードのグループ郡群を作る方法でした。それに対し、SDCの表セル秘匿では、統計表の変数の区分を変えることなく、公開すると危険なセル値を秘匿する手法をとります。ただし、統計表は線形の連立方程式を内包しているため、隠した値が逆算されないための2次秘匿処理が必要で、そこには複雑な最適化問題を解く必要があります。
今回紹介した表セル秘匿は、SDCの代表的な手法の一つです。SDCにはこのほかにもさまざまな手法があり、統計情報の有用性を維持しながら、個人や企業の情報を守るための研究が長年続けられてきました。表セル秘匿処理は技術的に興味深いので、また後日別の記事で詳しく解説したいと思います。
用語解説
- 調査票情報・・・統計調査において、調査対象となる個人や企業などから収集した回答内容の情報。
- セル秘匿・・・表の特定のセルの数値を非公開にし、秘匿したことを示す記号を付けること。
- カテゴリー統合・・・細かいカテゴリーを、より広いカテゴリーにまとめること。
- ミクロデータ・・・統計調査で集める、一人ひとり、一世帯ごと、一企業ごとの記録。
- 唯一性(uniqueness)・・・データの中で、同じ属性の組み合わせを持つ人が1人しかいないこと。
- 集計表・・・調査で集めたデータを項目やカテゴリーごとに整理し、それぞれに該当するミクロデータの数値データ(金額等)の合計、平均などを示した表です。例えば、地域別の所得合計や地域別の人口や業種別の売上総額をまとめた表が該当します。
- 度数表・・・データを項目やカテゴリーごとに分類し、それぞれに該当する人数や件数(度数)を示した表です。例えば、年齢階級ごとの人口や、業種ごとの企業数をまとめた表が該当します。
過去の記事で登場した専門用語
参考文献
- Ivan P. Fellegi, “On the Question of Statistical Confidentiality,” Journal of the American Statistical Association, Vol. 67, No. 337, pp. 7–18, 1972.
- Tore Dalenius, “Finding a Needle In a Haystack or Identifying Anonymous Census Records,” Journal of Official Statistics, Vol. 2, No. 3, pp. 329–336, 1986.
- Latanya Sweeney, “k-Anonymity: A Model for Protecting Privacy,” International Journal of Uncertainty, Fuzziness and Knowledge-Based Systems, Vol. 10, No. 5, pp. 557–570, 2002.
- Anco Hundepool et al., “Statistical Disclosure Control,” Wiley, 2012.